基于大数据的电子产品销售数据分析系统源码设计与文档
一、系统概述
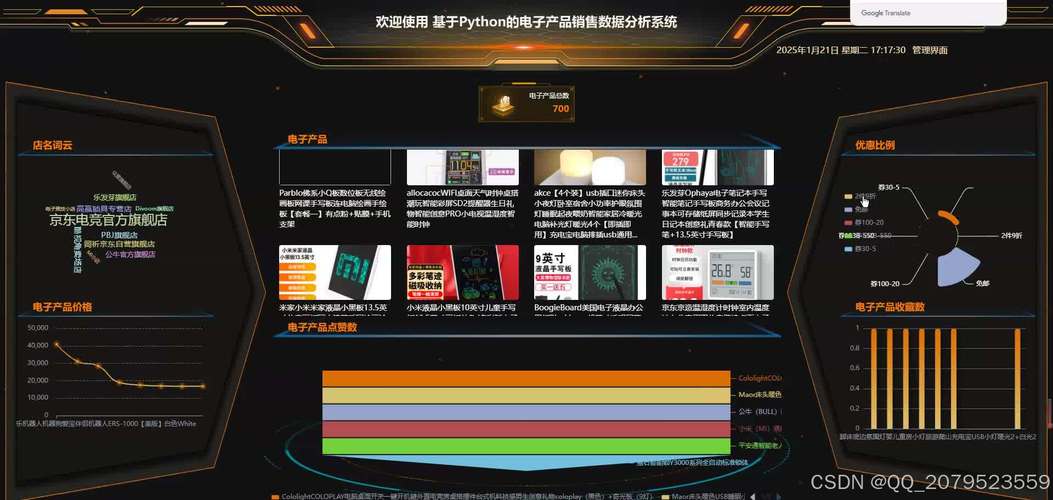
本系统旨在构建一个基于大数据的电子产品销售数据分析平台,通过对销售数据的采集、存储、处理与分析,为企业提供销售趋势洞察、产品表现评估和决策支持。系统涵盖数据采集、数据仓库、分析引擎、可视化展示等模块,适合作为毕业设计或企业级分析系统的参考实现。
二、需求分析
2.1 功能需求
- 数据采集:支持从业务数据库、日志文件、CSV等数据源抽取销售数据。
- 数据清洗与转换:处理缺失值、异常值,统一数据格式。
- 数据存储:使用HDFS/Hive进行海量数据存储,支持分区与压缩。
- 数据分析:
- 销售趋势分析(按日/月/季度)
- 产品维度分析(品类、品牌、型号销量与销售额排行)
- 区域销售分析(省份/城市分布)
- 用户行为分析(复购率、客单价)
- 可视化展示:通过Web仪表盘展示图表与关键指标。
- 系统管理:用户权限管理、任务调度与监控。
2.2 非功能需求
- 可扩展性:支持数据量增长与业务模块扩展。
- 性能:针对TB级数据实现分钟级查询响应。
- 可靠性:保障数据一致性与任务容错。
三、系统架构设计
采用分层架构,自下而上分为:
- 数据源层:业务数据库(MySQL)、日志文件、外部数据接口。
- 数据采集层:Flume采集日志,Sqoop抽取关系型数据,Canal监控增量。
- 数据存储层:HDFS存储原始数据,Hive构建数据仓库(ODS、DWD、DWS、ADS分层)。
- 计算分析层:Spark进行批处理与交互式分析(Spark SQL),Hive on Spark;可选Flink实现实时分析。
- 应用层:Spring Boot后端提供REST API,前端使用Vue + ECharts展示报表。
- 运维管理:Azkaban或DolphinScheduler调度任务,Prometheus+Grafana监控。
四、数据仓库设计
4.1 分层模型
- ODS层:原始数据贴源存储,按日期分区。
- DWD层:清洗后的明细数据,进行维度关联与退化。
- DWS层:按主题聚合的宽表(如每日产品销量、区域销售汇总)。
- ADS层:面向应用的结果表(如销售趋势表、产品TOP排行表)。
4.2 主要表结构示例
ods<em>sales</em>raw:原始销售订单数据(orderid, productid, quantity, price, saletime, storeid, region)dwd<em>sales</em>detail:清洗后明细(加入产品维度、时间维度)dws<em>product</em>daily:每日产品销量与销售额ads<em>sales</em>trend:按月销售趋势指标ads<em>product</em>rank:产品销售额排行榜
五、关键代码实现(Spark SQL分析示例)
`scala
// 读取Hive表:dwdsalesdetail
val salesDF = spark.sql("SELECT * FROM dwdsalesdetail WHERE dt='2024-01-01'")
// 1. 销售趋势分析(按月)
val monthlyTrend = salesDF
.withColumn("month", dateformat($"saletime", "yyyy-MM"))
.groupBy("month")
.agg(sum($"quantity").as("totalqty"), sum($"amount").as("totalamount"))
.orderBy("month")
monthlyTrend.write.mode("overwrite").insertInto("adssalestrend")
// 2. 产品品类销售额TOP10
val categoryTop10 = salesDF
.groupBy("category")
.agg(sum($"amount").as("totalamount"))
.orderBy(desc("totalamount"))
.limit(10)
categoryTop10.write.mode("overwrite").saveAsTable("adscategorytop10")
// 3. 区域销售分布(按省份)
val regionDist = salesDF
.groupBy("province")
.agg(sum($"amount").as("amount"))
regionDist.write.mode("overwrite").insertInto("adsregionsales")`
六、系统部署与运行
- 环境准备:Hadoop 3.x、Hive 3.x、Spark 3.x、MySQL、Zookeeper、Kafka(可选)。
- 数据初始化:创建Hive数据库与表,导入模拟数据(可使用脚本生成)。
- 提交Spark作业:使用
spark-submit执行分析脚本,或通过调度平台每日定时运行。 - 启动后端服务:运行Spring Boot应用,访问API接口。
- 前端访问:启动Vue项目,或打包后部署至Nginx。
七、文档说明
- 源码结构:
/data-collect(采集模块)、/warehouse(Hive SQL)、/analysis(Spark作业)、/web-api(Spring Boot)、/web-ui(Vue前端)。 - 接口文档:使用Swagger生成REST API文档,访问
/swagger-ui.html。 - 配置文件:各模块配置文件(如
application.yml、spark-defaults.conf)中需修改实际环境参数。 - 数据字典:见doc/schema.md,涵盖所有表字段说明。
- 测试数据集:提供模拟数据生成脚本
gen<em>mock</em>data.py,存放于/data/mock/。
八、
本系统提供了从数据采集到可视化分析的全链路设计方案,结合大数据技术栈实现了电子产品销售数据的多维分析。源码结构清晰,文档配套完整,可作为学习大数据项目开发或毕业设计的实践参考。后续可扩展个性化推荐、库存预测等高级分析模块。
如若转载,请注明出处:http://www.tsopal.com/product/117.html
更新时间:2026-11-21 14:05:01